

Emissionsfaktor-Matching ist ein Denkproblem, keine Datenbankabfrage
Discover this blog post
Carbon+Alt+Delete hat drei hochmoderne Algorithmen für das Emissionsfaktor-Matching anhand eines realistischen Beschaffungsdatensatzes verglichen. Ziel war es zu verstehen, welcher Matching-Ansatz in der Praxis am besten abschneidet und welche Eigenschaften hochwertiges von schlechtem Matching unterscheiden. Die Ergebnisse zeigen, dass auf logischem Schlussfolgern (Reasoning) basierende Ansätze traditionelle, auf Retrieval basierende Ansätze übertreffen, wobei open-climate.ai die insgesamt stärkste Leistung erzielte.
Einleitung
Das Matching von Emissionsfaktoren (EF) ist einer der wichtigsten und zeitaufwändigsten Schritte in der CO₂-Bilanzierung, insbesondere bei Scope-3-Daten. Beschaffungsdaten sind unübersichtlich, Produktbeschreibungen sind mehrdeutig, und die manuelle Auswahl des richtigen Emissionsfaktors erfordert oft erhebliches Fachwissen. Jüngste Fortschritte in der KI ermöglichen es, einen Großteil dieser Arbeit zu automatisieren. Damit ist KI-gestütztes EF-Matching der vielversprechendste Weg, um hochwertige CO₂-Bilanzierung zu skalieren.
Doch der Einsatz von KI bringt eine neue Herausforderung mit sich: Wie bewertet man die Qualität eines EF-Matching-Algorithmus? Anders als traditionelle Software liefern KI-Systeme fast immer eine Antwort. Die eigentliche Frage ist, ob diese Antwort korrekt, belastbar und verwendbar ist. Ein Modell, das selbstbewusst den falschen Faktor auswählt, kann mehr Arbeit verursachen, als es einspart, während ein Modell, das sorgfältig über Kontext, Materialien, Einheiten und Unsicherheit nachdenkt, den manuellen Prüfaufwand drastisch reduzieren kann.
In diesem Blog untersuchen wir, warum EF-Matching grundsätzlich ein schwieriges Problem ist und wie die Matching-Qualität in der Praxis bewertet werden sollte. Anschließend stellen wir die Ergebnisse eines Benchmarks vor, der drei verschiedene EF-Matching-Ansätze vergleicht. Dabei prüfen wir nicht nur, ob sie einen Faktor finden, sondern ob sie den richtigen Faktor finden und ihn in einer Form liefern, die direkt angewendet werden kann.
Matching ist Reasoning, nicht Retrieval
Das ist die zentrale These, deshalb stellen wir sie an den Anfang. EF-Matching ist der Prozess, bei dem man eine Beschaffungsposition, etwa eine Bestellung, eine Rechnungsposition oder einen Ausgabendatensatz, nimmt und den Emissionsfaktor identifiziert, der das gekaufte Produkt oder die gekaufte Dienstleistung am besten abbildet. KI kann dies tun, indem sie die Ähnlichkeit zwischen den Wörtern in der Beschaffungsposition und dem Emissionsfaktor bewertet.
Ein Ähnlichkeits-Matcher ist nur so gut wie die textliche Überschneidung zwischen einer Beschaffungsposition und einem Faktornamen. Genau diese Überschneidung zerstören echte Beschaffungsdaten: Markencodes
haben kein Wort mit dem Material gemeinsam, Fachjargon bedeutet einem Suchfeld nichts, Aktivitäten mit Abfallbezeichnung sehen textlich identisch aus wie Primärrohstoffe, und ein perfekter Faktorname ist nutzlos, wenn er in der falschen Einheit angegeben ist.
Ein Agent, der schlussfolgert, entschlüsselt Moplen zu Polypropylen, bevor er sucht, verwirft einen Dünger, wenn die Position flüssigen Stickstoff als Industriegas meint, bevorzugt Stahlproduktion gegenüber Schrottbehandlung und rechnet 2.400 Liter Öl in die Kilogramm um, die der Faktor erwartet. Es ist das Urteilsvermögen, das ein Berater manuell anwendet, nur konsistent, im Maßstab ganzer Dateien und mit jeder protokollierten Annahme.
Größere Datenbanken helfen: Mehr Quellen bedeuten mehr Chancen, dass der exakte Faktor irgendwo existiert. Aber Abdeckung und Matching sind unterschiedliche Probleme. Den richtigen Faktor im Katalog zu haben, hilft nicht, wenn das Tool nicht erkennen kann, zu welcher Position er gehört, oder ihn in einer Einheit zurückgibt, mit der die Position nichts anfangen kann.
Warum es schwieriger ist, als es aussieht
Die Schwierigkeit liegt in den Daten. Einige der Fallstricke beim Matching von Emissionsfaktoren mit Beschaffungsbüchern:
· Undurchsichtige, kontextabhängige Spalten. Eine Position ergibt oft nur im Kontext der gesamten Datei einen Sinn: der Lieferant, die anderen Artikel, die Tätigkeit des Unternehmens. Ein kryptischer Code oder eine bloße Teilenummer ist entschlüsselbar, sobald man den Rest der Tabelle gelesen und den Geschäftskontext erschlossen hat, und bedeutungslos, wenn man sie Zeile für Zeile betrachtet. Dieser Kontext ist das, was ein Mensch normalerweise hat, und genau das, was ein zeilenweiser Matcher wegwirft.
· Marken- und Handelsnamen. Lexan, Zamak, Moplen sind als Text bedeutungslos, aber es handelt sich um Polycarbonat, eine Zinklegierung und Polypropylen.
· Branchenjargon. Codes, Güten und Fachbegriffe, die für einen Ingenieur ein ganz bestimmtes Material bedeuten und für ein Suchfeld nichts.
· Einheiten, die nicht zusammenpassen. Wasser wird in m³ gekauft, Öl in Litern, aber die Emissionsfaktoren sind pro kg verfügbar. Der richtige Faktor in der falschen Einheit ist nutzlos, bis jemand ihn umrechnet.
· Gleiches Wort, andere Sache. Flüssiger Stickstoff ist ein Industriegas, kein Stickstoffdünger. Ein Kraftliner ist Karton, kein Stahlliner.
· Primärmaterial vs. Abfall. Ein gekauftes Stahlcoil ist Stahlproduktion, keine Behandlung von Stahlschrott, eine völlig andere Zahl.
Und das Material richtig zu benennen, ist nur die halbe Arbeit. Eine Bibliothek wie ecoinvent enthält Dutzende Varianten desselben Materials, die sich nach Produktionsweg und Geografie unterscheiden. „Stahl“ umfasst primären Hochofenstahl und recycelten Elektrolichtbogenstahl, deren Faktoren sich um ein Mehrfaches unterscheiden; bei „Strom“ ist die Spanne zwischen einem Wasserkraftnetz und einem Kohlenetz noch größer. Wählt man die falsche Variante, erhält man stillschweigend eine falsche Zahl, keinen offensichtlichen Fehltreffer.
Wie man die Qualität von EF-Matching bewertet
KI-Matching findet immer einen Treffer, das liegt in der Natur generativer KI. Gleichzeitig gibt es beim EF-Matching nicht die eine richtige Lösung. Mehrere Experten könnten dieselbe Beschaffungsposition unterschiedlichen Emissionsfaktoren zuordnen. Die Frage ist also, wie man die Qualität von KI-gestütztem EF-Matching bewertet.
Wir bewerten die Qualität anhand von 2 Kriterien:
- Direkte Verwendbarkeit: Liegt der Faktor in einer Einheit vor, die zu Ihren Beschaffungsdaten passt? Wenn nicht, spart Ihnen das Matching keine Zeit.
- Qualität. Wie hoch ist die Qualität des Treffers, eingeteilt in 4 Kategorien?
- Exzellent: richtiges Material, richtige Spezifität.
- Akzeptabel: ein vertretbarer Proxy aus derselben Materialfamilie.
- Falsch: falsches Material oder falsche Kategorie oder ein Abfall-/Recyclingfaktor für einen Primärrohstoff.
- Kein Ergebnis.
Vergleich der Qualität von 3 EF-Matching-Algorithmen
Wir haben 3 hochmoderne Systeme auf dasselbe realistische Beschaffungsbuch angewendet: open-climate.ai und 2 kommerziell verfügbare Algorithmen. Die Qualität des Matchings wurde von einem menschlichen Experten in Kombination mit einem KI-Agenten bewertet, der speziell zur Beurteilung der Qualität von EF-Matches entwickelt wurde.
Die folgende Tabelle zeigt die Ergebnisse. Sie macht deutlich, dass open-climate.ai die anderen Algorithmen sowohl bei der direkten Verwendbarkeit als auch bei der Qualität übertrifft.
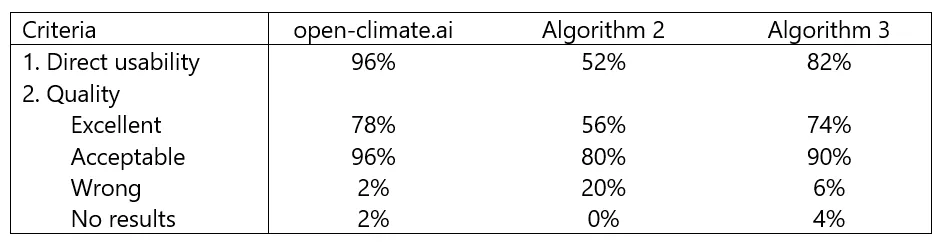
Der Test wurde mit einer anonymisierten, aber echten Beschaffungsdatei mit 50 Positionen durchgeführt. Sie enthielt die oben genannten typischen Schwierigkeiten: einfach benannte Rohstoffe, Marken- und Handelsnamen, die entschlüsselt werden müssen, Verwechslungs- und Abfallfallen sowie eine Mischung von Einheiten (kg, Liter, m³, Stückzahlen). Der Datensatz ist bewusst klein, spiegelt aber reale Beschaffungsdateien aus der Fertigung wider und bündelt genau die Arten von Mehrdeutigkeit, die den manuellen Prüfaufwand verursachen. Open-climate.ai ordnete dieser Beschaffungsdatei Emissionsfaktoren aus ecoinvent zu. Die 2 anderen Algorithmen nutzten ecoinvent und weitere Datenbanken.
Was die Zahlen sagen
- Die direkte Verwendbarkeit ist die entscheidende Kennzahl. Niemand berechnet einen Fußabdruck aus semantischer Ähnlichkeit; man berechnet ihn aus einem Faktor, der zur Position passt. Die 80 % Treffer in der richtigen Materialfamilie von Algorithmus 2 schrumpfen auf 52 %, sobald der Faktor zur Einheit der Position passen muss. Er lieferte ausgabenbasierte Faktoren in Fremdwährungen für Positionen, die in Kilogramm gemessen wurden, und ließ Positionen in Litern und m³ mit Faktoren pro Kilogramm stehen. Open-climate.ai rechnet die Menge in die Einheit des Faktors um, sodass der Treffer bei 96 % der Positionen angewendet werden kann.
- Die Abdeckung war nicht entscheidend. Um Matching-Kompetenz von der Kataloggröße zu trennen, haben wir Algorithmus 2 auch mit derselben einzelnen Bibliothek, ecoinvent, laufen lassen, und seine Qualität sank drastisch (0 % exzellent, 84 % falsch). Diese Zahl wirkt extrem, daher hier der Mechanismus: Ohne seine breiten ausgabenbasierten und EPD-Quellen hat ein Retrieval-Matcher keine Ausweichmöglichkeit, also liefert er den textlich nächsten Nachbarn, und in ecoinvent ist der textlich nächste Nachbar eines Primärmaterials oft dessen Abfall- oder Schrottbehandlungsaktivität, die eine völlig andere Zahl hat. Das ist kein Zufall; es ist das, was reines Retrieval tut, wenn die Breite es nicht mehr kaschiert.
- Vertrauen ist der Sinn der Automatisierung. Zeitersparnis gibt es nur, wenn man dem Tool genug vertraut, um nicht jede Position erneut zu prüfen. open-climate.ai markierte seine einzige falsche Auswahl zur Überprüfung, sodass sich die Aufmerksamkeit nur auf die Positionen richtet, bei denen es unsicher ist. Ein Tool, das falsche Treffer mit hoher Konfidenz ausgibt, erzwingt eine vollständige manuelle Prüfung von Tausenden von Positionen, also genau die Arbeit, die man vermeiden wollte. Abschließender Hinweis: Alle Benchmarking-Daten können unter [email protected] angefordert werden (d. h. Beschaffungsdatei, Rohausgaben und die zeilenweise Auswertung). Wir laden die Leser ein, den Test erneut durchzuführen, neu zu bewerten, uns zu widersprechen und uns die unübersichtlichste Beschaffungsdatei zu schicken, die Sie haben, um es mit Ihren eigenen Daten auszuprobieren.
Über Carbon+Alt+Delete
Wir bieten Software für CO₂-Bilanzierung für Nachhaltigkeitsberater und Beratungsunternehmen, die Unternehmen auf dem Weg zu Net Zero begleiten.
Neugierig, wie unsere Software Ihre Carbon-Accounting-Services verbessern kann?
Kontaktieren Sie uns unter [email protected] oder buchen Sie hier einen Termin mit einem unserer Experten.