

La asignación de factores de emisión es un problema de razonamiento, no una consulta a una base de datos
Discover this blog post
Carbon+Alt+Delete ha evaluado tres algoritmos de última generación para la asignación (matching) de factores de emisión con un conjunto de datos de compras realista. El objetivo era entender qué enfoque de matching funciona mejor en la práctica y qué características distinguen un matching de alta calidad de uno deficiente. Los resultados muestran que los enfoques basados en el razonamiento superan a los enfoques tradicionales basados en la recuperación (retrieval), y que open-climate.ai logra el mejor rendimiento global.
Introducción
La asignación de factores de emisión (FE) es uno de los pasos más importantes y que más tiempo consumen en la contabilidad de carbono, especialmente para los datos de Scope 3. Los datos de compras son desordenados, las descripciones de los productos son ambiguas y seleccionar manualmente el factor de emisión correcto suele requerir un conocimiento experto considerable. Los recientes avances en IA han permitido automatizar gran parte de este trabajo, lo que convierte el matching de FE impulsado por IA en la vía más prometedora para escalar una contabilidad de carbono de alta calidad.
Pero adoptar la IA plantea un nuevo reto: ¿cómo se evalúa la calidad de un algoritmo de matching de FE? A diferencia del software tradicional, los sistemas de IA casi siempre devuelven una respuesta. La verdadera cuestión es si esa respuesta es correcta, defendible y utilizable. Un modelo que selecciona con seguridad el factor equivocado puede generar más trabajo del que ahorra, mientras que un modelo que razona con cuidado sobre el contexto, los materiales, las unidades y la incertidumbre puede reducir drásticamente el esfuerzo de revisión manual.
En este blog analizamos por qué el matching de FE es, en esencia, un problema difícil y cómo debería evaluarse su calidad en la práctica. A continuación, presentamos los resultados de un benchmark que compara tres enfoques distintos de matching de FE, examinando no solo si encuentran un factor, sino si encuentran el factor correcto y lo devuelven en una forma que pueda aplicarse directamente.
El matching es razonamiento, no recuperación
Esta es toda la tesis, así que la planteamos primero. El matching de FE es el proceso de tomar una línea de compras, como una orden de compra, una línea de factura o un registro de gasto, e identificar el factor de emisión que mejor representa el producto o servicio adquirido. La IA puede hacerlo evaluando la similitud entre las palabras de la línea de compras y el factor de emisión.
Un matcher por similitud solo es tan bueno como la coincidencia textual entre una línea de compras y el nombre de un factor. Y es precisamente esa coincidencia la que los datos de compras reales rompen: los códigos de marca
no comparten ninguna palabra con el material, la jerga no significa nada para un buscador, las actividades con nombre de residuo parecen textualmente idénticas a los insumos vírgenes, y un nombre de factor perfecto es inútil si está expresado en la unidad equivocada.
Un agente que razona descifra que Moplen es polipropileno antes de buscar, descarta un fertilizante cuando la línea se refiere al nitrógeno líquido como gas industrial, prefiere la producción de acero frente al tratamiento de chatarra y convierte 2.400 litros de aceite en los kilogramos que espera el factor. Es el criterio que un consultor aplica manualmente, pero de forma coherente, a escala de archivo y con cada supuesto registrado.
Las bases de datos más grandes ayudan: más fuentes significan más posibilidades de que el factor exacto exista en algún lugar. Pero la cobertura y el matching son problemas distintos. Tener el factor correcto en el catálogo no sirve de nada si la herramienta no sabe a qué línea corresponde o lo devuelve en una unidad que la línea no puede usar.
Por qué es más difícil de lo que parece
La dificultad está en los datos. Algunas de las trampas al asignar factores de emisión a los registros de compras:
· Columnas opacas y dependientes del contexto. A menudo, una línea solo tiene sentido si se considera el archivo completo: el proveedor, los demás artículos, a qué se dedica la empresa. Un código críptico o un simple número de pieza se puede descifrar una vez leído el resto de la hoja e inferido el contexto empresarial, y carece de sentido si se mira fila por fila. Ese contexto es lo que normalmente tiene una persona y lo que un matcher línea por línea descarta.
· Marcas y nombres comerciales. Lexan, Zamak o Moplen no significan nada como texto, pero son policarbonato, una aleación de zinc y polipropileno.
· Jerga del sector. Códigos, grados y términos técnicos que para un ingeniero designan un material concreto y para un buscador no significan nada.
· Unidades que no coinciden. El agua se compra en m³ y el aceite en litros, pero los factores de emisión están disponibles por kg. El factor correcto en la unidad equivocada es inútil hasta que alguien lo convierte.
· La misma palabra, otra cosa. El nitrógeno líquido es un gas industrial, no un fertilizante nitrogenado. Un kraft liner es cartón, no un revestimiento de acero.
· Virgen frente a residuo. Una bobina de acero que se compra corresponde a la producción de acero, no al tratamiento de chatarra de acero, que es una cifra completamente distinta.
Y acertar con el nombre del material es solo la mitad del trabajo. Una biblioteca como ecoinvent contiene decenas de variantes del «mismo» material, que difieren según la ruta de producción y la geografía. El «acero» abarca desde el acero primario de alto horno hasta el acero reciclado de horno de arco eléctrico, cuyos factores difieren varias veces; la «electricidad» varía aún más entre una red hidroeléctrica y una de carbón. Si se elige la variante equivocada, se obtiene una cifra silenciosamente errónea, no un fallo evidente.
Cómo evaluar la calidad del matching de FE
El matching con IA siempre puede encontrar una coincidencia; esa es la naturaleza de la IA generativa. Al mismo tiempo, el matching de FE no tiene una única solución correcta. Varios expertos podrían asignar a la misma línea de compras un factor de emisión diferente. Así que la pregunta es cómo evaluar la calidad del matching de FE asistido por IA.
Evaluamos la calidad según 2 criterios:
- Usabilidad directa: ¿el factor viene en una unidad que corresponde a los datos de compras de los que dispone? Si no, el matching no le ahorra tiempo.
- Calidad. ¿Cuál es la calidad de la coincidencia, agrupada en 4 categorías?
- Excelente: material correcto, especificidad correcta.
- Aceptable: un proxy defendible de la misma familia.
- Incorrecto: material o categoría equivocados, o un factor de residuo/reciclaje para un insumo virgen.
- Sin resultado.
Comparación de la calidad de 3 algoritmos de matching de FE
Ejecutamos 3 sistemas de última generación sobre el mismo registro de compras realista: open-climate.ai y 2 algoritmos disponibles comercialmente. La calidad del matching fue evaluada por un experto humano en combinación con un agente de IA diseñado para evaluar la calidad de las asignaciones de FE.
La tabla siguiente muestra los resultados. Indica claramente que open-climate.ai supera a los demás algoritmos, tanto en usabilidad directa como en calidad.
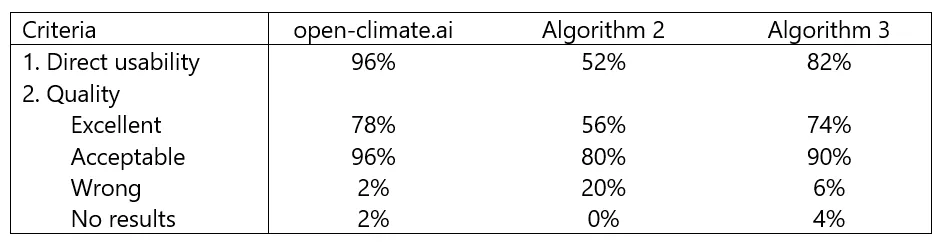
La prueba se realizó con un archivo de compras anonimizado pero real de 50 líneas. Incluía las dificultades típicas mencionadas anteriormente: materias primas con nombres sencillos, marcas y nombres comerciales que hay que descifrar, trampas de colisión y de residuos, y una mezcla de unidades (kg, litros, m³, número de unidades). El conjunto de datos es intencionadamente pequeño, pero refleja archivos de compras reales del sector manufacturero y concentra precisamente los tipos de ambigüedad que generan esfuerzo de revisión manual. Open-climate.ai asignó a este archivo de compras factores de emisión de ecoinvent. Los otros 2 algoritmos utilizaron ecoinvent y otras bases de datos.
Lo que dicen las cifras
- La usabilidad directa es la cifra que importa. Nadie calcula una huella a partir de la similitud semántica; se calcula a partir de un factor que encaja con la línea. El 80 % de coincidencias en la familia correcta del algoritmo 2 se desploma al 52 % cuando el factor tiene que encajar con la unidad de la línea. Devolvió factores basados en el gasto en monedas extranjeras para líneas medidas en kilogramos, y dejó líneas en litros y m³ con factores por kilogramo. Open-climate.ai convierte la cantidad a la unidad del factor, de modo que la coincidencia puede aplicarse en el 96 % de las líneas.
- La cobertura no fue decisiva. Para separar la capacidad de matching del tamaño del catálogo, también ejecutamos el algoritmo 2 con la misma biblioteca única, ecoinvent, y su calidad cayó bruscamente (0 % excelente, 84 % incorrecto). La cifra parece extrema, así que este es el mecanismo: privado de sus amplias fuentes basadas en el gasto y en EPD, un matcher de recuperación no tiene a qué recurrir, así que devuelve el vecino textual más cercano, y en ecoinvent el vecino textual más cercano a un material virgen suele ser su actividad de tratamiento de residuos o chatarra, que tiene una cifra completamente diferente. No es una casualidad; es lo que hace la recuperación pura cuando la amplitud deja de disimularlo.
- La confianza es el objetivo de automatizar. El ahorro de tiempo solo se mantiene si se confía lo suficiente en la herramienta como para no volver a revisar cada línea. open-climate.ai marcó para revisión su única elección incorrecta, de modo que la atención se centra solo en las líneas sobre las que tiene dudas. Una herramienta que entrega coincidencias erróneas con alta confianza obliga a hacer una revisión manual completa de miles de líneas, que es justo el trabajo que se quería evitar. Nota final: todos los datos del benchmark pueden solicitarse en [email protected] (es decir, el archivo de compras, los resultados sin procesar y el análisis línea por línea). Invitamos a los lectores a volver a ejecutarlo, volver a evaluarlo, discrepar con nosotros y enviarnos el archivo de compras más desordenado que tengan para probarlo con sus propios datos.
Sobre Carbon+Alt+Delete
Ofrecemos software de contabilidad de carbono para consultores de sostenibilidad y consultoras que guían a las empresas hacia el net zero.
¿Quiere descubrir cómo nuestro software puede mejorar sus servicios de contabilidad de carbono?
Escríbanos a [email protected] o reserve una reunión con uno de nuestros expertos aquí.