

L’appariement des facteurs d’émission est un problème de raisonnement, pas une recherche dans une base de données
Discover this blog post
Carbon+Alt+Delete a comparé trois algorithmes de pointe d’appariement (matching) des facteurs d’émission sur un jeu de données d’achats réaliste. L’objectif était de comprendre quelle approche d’appariement fonctionne le mieux en pratique et quelles caractéristiques distinguent un appariement de haute qualité d’un appariement médiocre. Les résultats montrent que les approches fondées sur le raisonnement surpassent les approches traditionnelles fondées sur la recherche (retrieval), open-climate.ai obtenant les meilleures performances globales.
Introduction
L’appariement des facteurs d’émission (FE) est l’une des étapes les plus importantes et les plus chronophages de la comptabilité carbone, en particulier pour les données du Scope 3. Les données d’achats sont désordonnées, les descriptions de produits sont ambiguës et la sélection manuelle du bon facteur d’émission exige souvent une expertise considérable. Les progrès récents de l’IA permettent d’automatiser une grande partie de ce travail, ce qui fait de l’appariement des FE par IA la voie la plus prometteuse pour déployer à grande échelle une comptabilité carbone de haute qualité.
Mais l’adoption de l’IA pose un nouveau défi : comment évaluer la qualité d’un algorithme d’appariement des FE ? Contrairement aux logiciels traditionnels, les systèmes d’IA renvoient presque toujours une réponse. La vraie question est de savoir si cette réponse est correcte, défendable et exploitable. Un modèle qui sélectionne avec assurance le mauvais facteur peut créer plus de travail qu’il n’en économise, tandis qu’un modèle qui raisonne soigneusement sur le contexte, les matériaux, les unités et l’incertitude peut réduire considérablement l’effort de vérification manuelle.
Dans cet article, nous examinons pourquoi l’appariement des FE est fondamentalement un problème difficile et comment sa qualité doit être évaluée en pratique. Nous présentons ensuite les résultats d’un benchmark comparant trois approches d’appariement des FE, en examinant non seulement si elles trouvent un facteur, mais si elles trouvent le bon facteur et le renvoient sous une forme directement applicable.
L’appariement est un raisonnement, pas une recherche
C’est toute notre thèse, nous la plaçons donc en premier. L’appariement des FE consiste à prendre une ligne d’achat, comme un bon de commande, une ligne de facture ou un enregistrement de dépense, et à identifier le facteur d’émission qui représente le mieux le produit ou le service acheté. L’IA peut le faire en évaluant la similarité entre les mots de la ligne d’achat et le facteur d’émission.
Un outil d’appariement par similarité ne vaut que par le recoupement textuel entre une ligne d’achat et le nom d’un facteur. Or c’est précisément ce recoupement que les données d’achats réelles mettent à mal : les codes de marque
n’ont aucun mot en commun avec le matériau, le jargon ne signifie rien pour un moteur de recherche, les activités portant un nom de déchet semblent textuellement identiques aux matières vierges, et un nom de facteur parfait est inutile s’il est exprimé dans la mauvaise unité.
Un agent qui raisonne décode Moplen en polypropylène avant de chercher, écarte un engrais lorsque la ligne désigne l’azote liquide en tant que gaz industriel, préfère la production d’acier au traitement de la ferraille et convertit 2 400 litres d’huile en kilogrammes attendus par le facteur. C’est le jugement qu’un consultant applique à la main, mais appliqué de manière cohérente, à l’échelle d’un fichier entier, avec chaque hypothèse consignée.
Des bases de données plus vastes aident : plus de sources signifie plus de chances que le facteur exact existe quelque part. Mais la couverture et l’appariement sont deux problèmes différents. Avoir le bon facteur dans le catalogue ne sert à rien si l’outil ne sait pas à quelle ligne il correspond ou le renvoie dans une unité que la ligne ne peut pas utiliser.
Pourquoi c’est plus difficile qu’il n’y paraît
La difficulté réside dans les données. Voici quelques-uns des pièges lorsqu’on apparie des facteurs d’émission à des registres d’achats :
· Des colonnes opaques et dépendantes du contexte. Une ligne n’a souvent de sens qu’au regard de l’ensemble du fichier : le fournisseur, les autres articles, l’activité de l’entreprise. Un code cryptique ou un simple numéro de pièce devient déchiffrable une fois qu’on a lu le reste de la feuille et déduit le contexte métier, mais il n’a aucun sens si on l’examine ligne par ligne. Ce contexte est ce dont dispose habituellement un humain, et c’est ce qu’un outil d’appariement ligne par ligne laisse de côté.
· Marques et noms commerciaux. Lexan, Zamak, Moplen ne veulent rien dire en tant que texte, mais ce sont du polycarbonate, un alliage de zinc et du polypropylène.
· Jargon sectoriel. Des codes, des nuances et des termes techniques qui désignent un matériau précis pour un ingénieur et rien pour un moteur de recherche.
· Des unités qui ne concordent pas. L’eau est achetée en m³, l’huile en litres, mais les facteurs d’émission sont disponibles par kg. Le bon facteur dans la mauvaise unité est inutile tant que personne ne le convertit.
· Même mot, autre chose. L’azote liquide est un gaz industriel, pas un engrais azoté. Un kraft liner est du carton, pas un revêtement en acier.
· Vierge ou déchet. Une bobine d’acier que vous achetez relève de la production d’acier, pas du traitement de la ferraille, soit un chiffre totalement différent.
Et trouver le bon nom de matériau n’est que la moitié du travail. Une bibliothèque comme ecoinvent contient des dizaines de variantes du « même » matériau, qui diffèrent selon la filière de production et la géographie. L’« acier » couvre l’acier primaire de haut fourneau et l’acier recyclé de four à arc électrique, dont les facteurs varient du simple au multiple ; l’« électricité » varie encore davantage entre un réseau hydroélectrique et un réseau au charbon. Choisissez la mauvaise variante et vous obtenez un chiffre discrètement faux, pas une erreur évidente.
Comment évaluer la qualité de l’appariement des FE
L’appariement par IA trouve toujours une correspondance, c’est la nature même de l’IA générative. Dans le même temps, l’appariement des FE n’a pas une seule solution correcte. Plusieurs experts pourraient associer la même ligne d’achat à un facteur d’émission différent. La question est donc de savoir comment évaluer la qualité de l’appariement des FE assisté par IA.
Nous évaluons la qualité selon 2 critères :
- Utilisabilité directe : le facteur est-il exprimé dans une unité correspondant à vos données d’achats ? Sinon, l’appariement ne vous fait pas gagner de temps.
- Qualité. Quelle est la qualité de la correspondance, répartie en 4 catégories ?
- Excellente : bon matériau, bonne spécificité.
- Acceptable : un proxy défendable de la même famille.
- Fausse : mauvais matériau ou mauvaise catégorie, ou facteur de déchet/recyclage pour une matière vierge.
- Aucun résultat.
Comparaison de la qualité de 3 algorithmes d’appariement des FE
Nous avons fait tourner 3 systèmes de pointe sur le même registre d’achats réaliste : open-climate.ai et 2 algorithmes disponibles dans le commerce. La qualité de l’appariement a été évaluée par un expert humain, en combinaison avec un agent d’IA conçu pour évaluer la qualité des correspondances de FE.
Le tableau ci-dessous présente les résultats. Il montre clairement que open-climate.ai surpasse les autres algorithmes, tant en utilisabilité directe qu’en qualité.
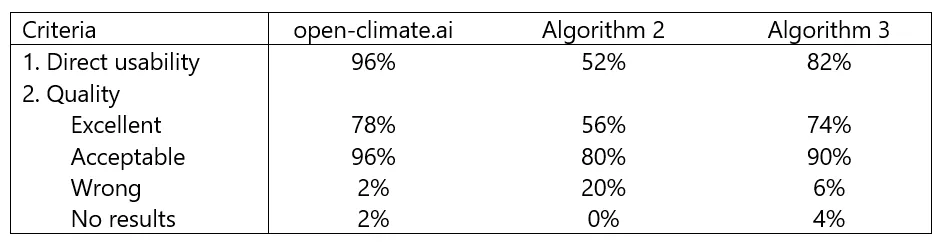
Le test a été réalisé sur un fichier d’achats anonymisé mais réel de 50 lignes. Il comportait les difficultés typiques évoquées ci-dessus : matières premières désignées simplement, marques et noms commerciaux à décoder, pièges de collision et de déchets, et un mélange d’unités (kg, litres, m³, nombre d’articles). Le jeu de données est volontairement restreint, mais il reflète des fichiers d’achats industriels réels et concentre précisément les types d’ambiguïté qui génèrent l’effort de vérification manuelle. Open-climate.ai a apparié ce fichier d’achats avec des facteurs d’émission ecoinvent. Les 2 autres algorithmes utilisaient ecoinvent et d’autres bases de données.
Ce que disent les chiffres
- L’utilisabilité directe est le chiffre qui compte. Personne ne calcule une empreinte à partir d’une similarité sémantique ; on la calcule à partir d’un facteur adapté à la ligne. Les 80 % de correspondances dans la bonne famille de l’algorithme 2 tombent à 52 % dès que le facteur doit correspondre à l’unité de la ligne. Il a renvoyé des facteurs basés sur les dépenses en devises étrangères pour des lignes mesurées en kilogrammes, et a laissé des lignes en litres et en m³ avec des facteurs par kilogramme. Open-climate.ai convertit la quantité dans l’unité du facteur, de sorte que la correspondance peut être appliquée sur 96 % des lignes.
- La couverture n’a pas été déterminante. Pour distinguer la compétence d’appariement de la taille du catalogue, nous avons également fait tourner l’algorithme 2 sur la même bibliothèque unique, ecoinvent, et sa qualité a fortement chuté (0 % excellente, 84 % fausse). Ce chiffre semble extrême, voici donc le mécanisme : privé de ses larges sources basées sur les dépenses et sur les EPD, un outil d’appariement par recherche n’a aucune solution de repli ; il renvoie donc le voisin textuel le plus proche, et dans ecoinvent, le voisin textuel le plus proche d’une matière vierge est souvent son activité de traitement des déchets ou de la ferraille, dont le chiffre est totalement différent. Ce n’est pas un hasard ; c’est ce que fait la recherche pure lorsque l’étendue des sources ne le masque plus.
- La confiance est la raison d’être de l’automatisation. Le gain de temps n’est réel que si vous faites suffisamment confiance à l’outil pour ne pas revérifier chaque ligne. open-climate.ai a signalé pour vérification son unique choix erroné, de sorte que l’attention se porte uniquement sur les lignes pour lesquelles il a un doute. Un outil qui livre de mauvaises correspondances avec un niveau de confiance élevé impose une vérification manuelle complète de milliers de lignes, soit précisément le travail que vous cherchiez à éviter. Remarque finale : toutes les données du benchmark peuvent être demandées à [email protected] (c’est-à-dire le fichier d’achats, les résultats bruts et l’analyse ligne par ligne). Nous invitons les lecteurs à le relancer, à le réévaluer, à nous contredire et à nous envoyer le fichier d’achats le plus désordonné dont vous disposez pour l’essayer sur vos propres données.
À propos de Carbon+Alt+Delete
Nous fournissons un logiciel de comptabilité carbone pour les consultants en durabilité et les entreprises de conseil qui guident les entreprises vers le net zéro.
Curieux de découvrir comment notre logiciel peut améliorer vos services de comptabilité carbone ?
N’hésitez pas à nous contacter via [email protected] ou à réserver un rendez-vous avec l’un de nos experts ici.