

Emissiefactor-matching is een redeneerprobleem, geen databankopzoeking
Discover this blog post
Carbon+Alt+Delete heeft drie geavanceerde algoritmes voor emissiefactor-matching gebenchmarkt op een realistische aankoopdataset. Het doel was te begrijpen welke matching-aanpak in de praktijk het best presteert en welke kenmerken matching van hoge kwaliteit onderscheiden van slechte matching. De resultaten tonen dat benaderingen op basis van redeneren beter presteren dan traditionele benaderingen op basis van retrieval, waarbij open-climate.ai de sterkste algemene prestaties neerzet.
Inleiding
Emissiefactor (EF)-matching is een van de belangrijkste en meest tijdrovende stappen in carbon accounting, in het bijzonder voor Scope 3-data. Aankoopdata zijn rommelig, productomschrijvingen zijn dubbelzinnig en het handmatig selecteren van de juiste emissiefactor vraagt vaak aanzienlijke vakkennis. Recente vooruitgang in AI maakt het mogelijk om een groot deel van dit werk te automatiseren, waardoor AI-gestuurde EF-matching de meest veelbelovende weg is om carbon accounting van hoge kwaliteit op te schalen.
Maar het gebruik van AI brengt een nieuwe uitdaging met zich mee: hoe beoordeel je de kwaliteit van een EF-matching-algoritme? Anders dan traditionele software geven AI-systemen bijna altijd een antwoord. De echte vraag is of dat antwoord correct, verdedigbaar en bruikbaar is. Een model dat vol zelfvertrouwen de verkeerde factor kiest, kan meer werk veroorzaken dan het bespaart, terwijl een model dat zorgvuldig redeneert over context, materialen, eenheden en onzekerheid de manuele controle drastisch kan verminderen.
In deze blog onderzoeken we waarom EF-matching in wezen een moeilijk probleem is en hoe de kwaliteit van matching in de praktijk beoordeeld moet worden. Daarna presenteren we de resultaten van een benchmark die drie verschillende EF-matching-benaderingen vergelijkt. We kijken daarbij niet alleen of ze een factor vinden, maar ook of ze de juiste factor vinden en die teruggeven in een vorm die rechtstreeks toegepast kan worden.
Matching is redeneren, geen retrieval
Dit is de volledige these, dus we zetten ze vooraan. EF-matching is het proces waarbij je een aankooplijn neemt, zoals een bestelbon, factuurlijn of uitgavenrecord, en de emissiefactor identificeert die het aangekochte product of de aangekochte dienst het best weergeeft. AI kan dat doen door de gelijkenis te beoordelen tussen de woorden in de aankooplijn en de emissiefactor.
Een gelijkenis-matcher is maar zo goed als de tekstuele overlap tussen een aankooplijn en de naam van een factor. Net die overlap is wat echte aankoopdata onderuithalen: merkcodes
hebben geen enkel woord gemeen met het materiaal, jargon betekent niets voor een zoekveld, activiteiten met een afvalnaam lijken tekstueel identiek aan primaire grondstoffen, en een perfecte factornaam is nutteloos als die in de verkeerde eenheid is uitgedrukt.
Een agent die redeneert, decodeert Moplen naar polypropyleen voordat hij zoekt, verwerpt een meststof wanneer de lijn vloeibare stikstof als industrieel gas bedoelt, verkiest staalproductie boven schrootverwerking en zet 2.400 liter olie om naar de kilogram die de factor verwacht. Het is het oordeel dat een consultant manueel toepast, maar dan consistent, op de schaal van een volledig bestand en met elke aanname gelogd.
Grotere databanken helpen: meer bronnen betekenen meer kans dat de exacte factor ergens bestaat. Maar dekking en matching zijn verschillende problemen. De juiste factor in de catalogus hebben helpt niet als de tool niet kan bepalen bij welke lijn hij hoort, of hem teruggeeft in een eenheid waar de lijn niets mee kan.
Waarom het moeilijker is dan het lijkt
De moeilijkheid zit in de data. Enkele valkuilen bij het matchen van emissiefactoren met aankoopregisters:
· Ondoorzichtige, contextafhankelijke kolommen. Een lijn is vaak pas zinvol als je het volledige bestand in beschouwing neemt: de leverancier, de andere items, wat het bedrijf doet. Een cryptische code of een kaal onderdeelnummer is te ontcijferen zodra je de rest van het blad hebt gelezen en de bedrijfscontext hebt afgeleid, en betekenisloos als je het rij per rij bekijkt. Die context is wat een mens meestal heeft, en precies wat een lijn-per-lijn-matcher weggooit.
· Merk- en handelsnamen. Lexan, Zamak en Moplen zeggen als tekst niets, maar het zijn polycarbonaat, een zinklegering en polypropyleen.
· Vakjargon. Codes, kwaliteiten en technische termen die voor een ingenieur één specifiek materiaal betekenen en voor een zoekveld niets.
· Eenheden die niet overeenkomen. Water wordt aangekocht in m³, olie in liter, maar de emissiefactoren zijn beschikbaar per kg. De juiste factor in de verkeerde eenheid is nutteloos tot iemand hem omrekent.
· Hetzelfde woord, iets anders. Vloeibare stikstof is een industrieel gas, geen stikstofmeststof. Een kraftliner is karton, geen stalen liner.
· Primair vs. afval. Een stalen coil die je aankoopt, is staalproductie, geen verwerking van staalschroot, een totaal ander getal.
En de materiaalnaam juist krijgen is maar de helft van het werk. Een bibliotheek als ecoinvent bevat tientallen varianten van “hetzelfde” materiaal, die verschillen naargelang productieroute en geografie. “Staal” omvat primair hoogovenstaal en gerecycleerd vlamboogstaal, waarvan de factoren meervoudig verschillen; bij “elektriciteit” is het verschil tussen een net op waterkracht en een net op steenkool nog groter. Kies je de verkeerde variant, dan krijg je ongemerkt een fout getal, geen duidelijke misser.
Hoe beoordeel je de kwaliteit van EF-matching?
AI-matching vindt altijd een match, dat is de aard van generatieve AI. Tegelijk heeft EF-matching niet één correcte oplossing. Verschillende experts kunnen dezelfde aankooplijn aan een andere emissiefactor koppelen. De vraag is dus hoe je de kwaliteit van AI-gestuurde EF-matching beoordeelt.
We beoordelen de kwaliteit op basis van 2 criteria:
- Directe bruikbaarheid: komt de factor in een eenheid die overeenkomt met de aankoopdata die je hebt? Zo niet, dan bespaart de matching je geen tijd.
- Kwaliteit. Wat is de kwaliteit van de match, ingedeeld in 4 categorieën?
- Uitstekend: juist materiaal, juiste specificiteit.
- Aanvaardbaar: een verdedigbare proxy uit dezelfde familie.
- Fout: verkeerd materiaal of verkeerde categorie, of een afval-/recyclagefactor voor een primaire grondstof.
- Geen resultaat.
De kwaliteit van 3 EF-matching-algoritmes vergeleken
We lieten 3 geavanceerde systemen draaien op hetzelfde realistische aankoopregister: open-climate.ai en 2 commercieel beschikbare algoritmes. De kwaliteit van de matching werd beoordeeld door een menselijke expert in combinatie met een AI-agent die ontwikkeld is om de kwaliteit van EF-matches te beoordelen.
De onderstaande tabel toont de resultaten. Ze geeft duidelijk aan dat open-climate.ai beter presteert dan de andere algoritmes, zowel op directe bruikbaarheid als op kwaliteit.
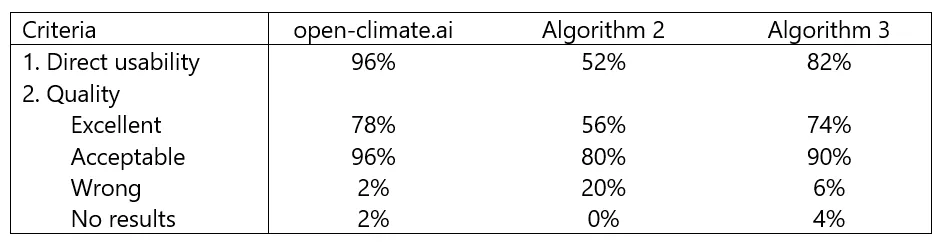
De test werd uitgevoerd op een geanonimiseerd maar echt aankoopbestand van 50 lijnen. Het bevatte de typische moeilijkheden die hierboven vermeld zijn: eenvoudig benoemde grondstoffen, merk- en handelsnamen die gedecodeerd moeten worden, verwarrings- en afvalvallen, en een mix van eenheden (kg, liter, m³, aantallen stuks). De dataset is bewust klein, maar weerspiegelt echte aankoopbestanden uit de maakindustrie en concentreert precies de soorten dubbelzinnigheid die manuele controle vereisen. Open-climate.ai matchte dit aankoopbestand met emissiefactoren van ecoinvent. De 2 andere algoritmes matchten met ecoinvent en andere databanken.
Wat de cijfers zeggen
- Directe bruikbaarheid is het cijfer dat telt. Niemand berekent een voetafdruk op basis van semantische gelijkenis; je berekent hem op basis van een factor die bij de lijn past. De 80% matches in de juiste familie van algoritme 2 zakken naar 52% zodra de factor bij de eenheid van de lijn moet passen. Het gaf uitgavengebaseerde factoren in vreemde valuta terug voor lijnen gemeten in kilogram, en liet lijnen in liter en m³ staan met factoren per kilogram. Open-climate.ai zet de hoeveelheid om naar de eenheid van de factor, zodat de match op 96% van de lijnen toegepast kan worden.
- Dekking was niet doorslaggevend. Om matchingvaardigheid te scheiden van cataloguslengte, lieten we algoritme 2 ook draaien op dezelfde enkele bibliotheek, ecoinvent, en de kwaliteit daalde sterk (0% uitstekend, 84% fout). Dat cijfer lijkt extreem, dus hier is het mechanisme: zonder zijn brede uitgavengebaseerde en EPD-bronnen heeft een retrieval-matcher niets om op terug te vallen, dus geeft hij de tekstueel dichtstbijzijnde buur terug, en in ecoinvent is de tekstueel dichtstbijzijnde buur van een primair materiaal vaak de afval- of schrootverwerkingsactiviteit ervan, met een totaal ander getal. Het is geen toeval; het is wat pure retrieval doet wanneer de breedte het niet langer verdoezelt.
- Vertrouwen is waar automatisering om draait. Tijdswinst houdt alleen stand als je de tool genoeg vertrouwt om niet elke lijn opnieuw te controleren. open-climate.ai markeerde zijn enige foute keuze voor controle, zodat de aandacht alleen gaat naar de lijnen waarover het twijfelt. Een tool die foute matches met hoge zekerheid aflevert, dwingt tot een volledige manuele controle van duizenden lijnen, precies het werk dat je wilde vermijden. Tot slot: alle benchmarkdata kunnen aangevraagd worden via [email protected] (d.w.z. het aankoopbestand, de ruwe output en de lijn-per-lijnanalyse). We nodigen lezers uit om de test opnieuw uit te voeren, opnieuw te beoordelen, het met ons oneens te zijn en ons het rommeligste aankoopbestand te sturen dat je hebt, om het op je eigen data uit te proberen.
Over Carbon+Alt+Delete
Wij bieden carbon accounting-software voor duurzaamheidsconsultants en adviesbureaus die bedrijven begeleiden richting net zero.
Benieuwd hoe onze software jouw carbon accounting-diensten kan verbeteren?
Neem gerust contact op via [email protected] of boek hier een afspraak met een van onze experten.